Modele na twoim komputerze
Korzystaj z Ollama na wszystkich obsługiwanych platformach. Windows oferuje także wbudowany silnik i szybką konfigurację.
Po pobraniu modeli lokalne generowanie działa bez internetuOd pierwszej myśli do gotowego wyniku.
Pobierz AetherAI: czat AI z modelami lokalnymi, OpenRouter, Groq, Gemini, Cerebras i SambaNova. Agenci, narzędzia i preferencje odpowiedzi.
Windows · macOS · Linux · Lokalne generowanie bez subskrypcji
01 / MOŻLIWOŚCI
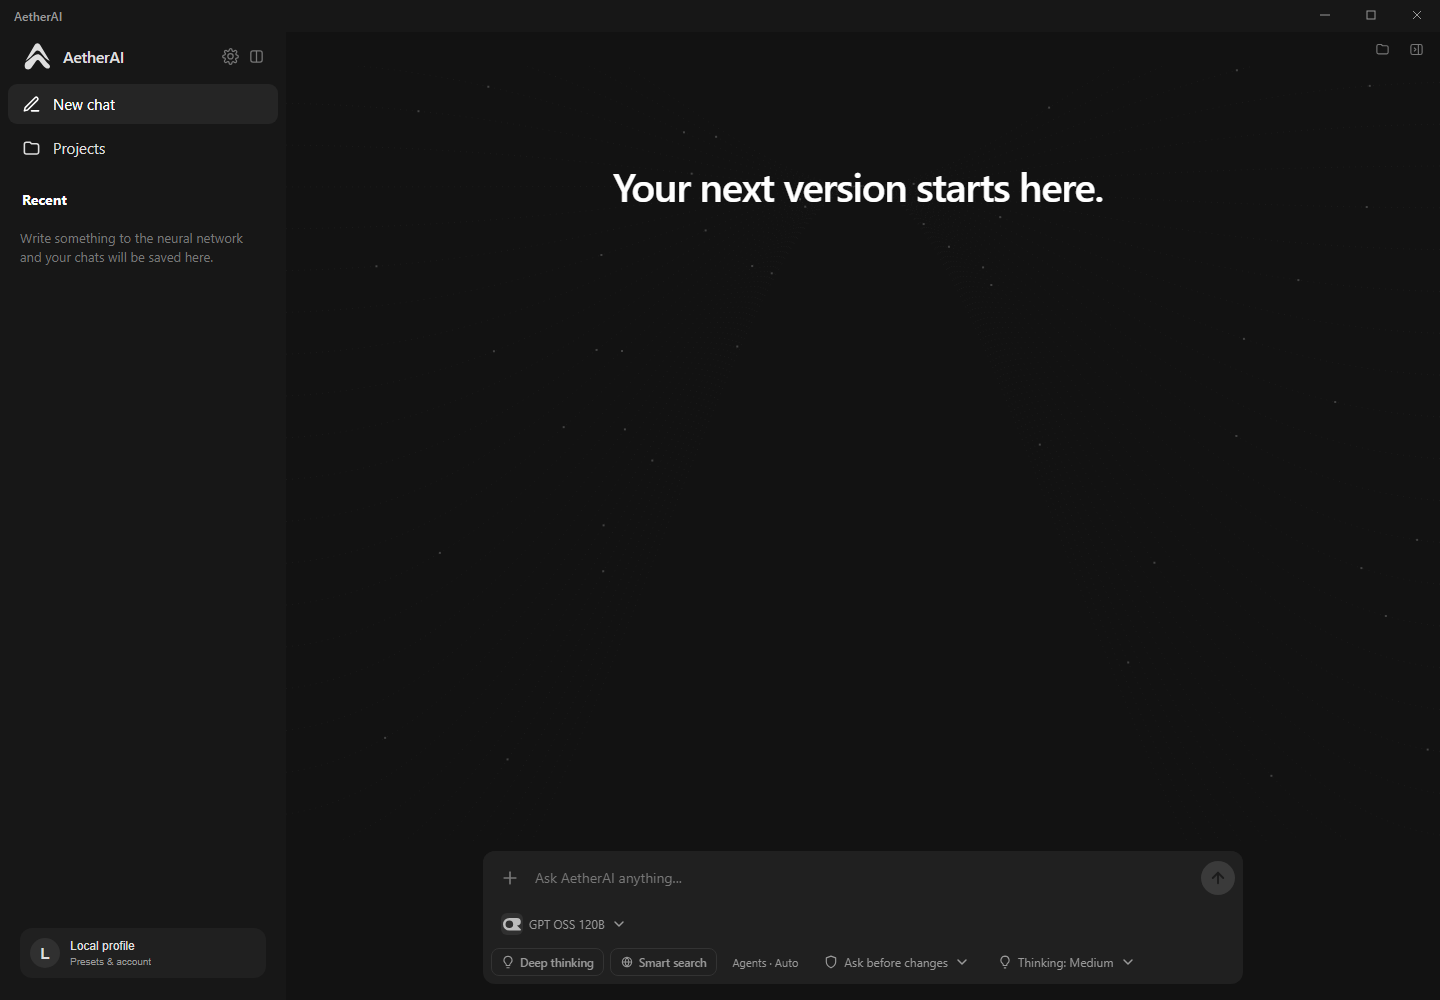
Wybierz modele i narzędzia odpowiednie do zadania.
Korzystaj z Ollama na wszystkich obsługiwanych platformach. Windows oferuje także wbudowany silnik i szybką konfigurację.
Po pobraniu modeli lokalne generowanie działa bez internetuKoordynator rozdziela odpowiednie części zadania między specjalistów. Obserwuj postęp, a główny model połączy wyniki.
Do dwóch specjalistów · Szybkość zależy od modelu i sprzętuPodłącz serwery MCP i Skills w Markdown. Workspace czyta projekty zgodnie z wybranymi uprawnieniami.
MCP · Skills · Zatwierdzanie działań02 / WEWNĄTRZ APLIKACJI
Zacznij od lokalnego czatu, potem dodaj narzędzia i modele chmurowe.
Szybka konfiguracja Windows pobiera silnik i Qwen 1.5B. Na macOS i Linux zainstaluj Ollama.
Modele pobiera się osobno. Większe modele potrzebują więcej pamięci.
03 / MASZ KONTROLĘ
Czat lokalny jest bezpłatny. Dostawcy mają własne bezpłatne limity i płatne plany. Modele w chmurze wymagają klucza API.
Wybierz uprawnienia. Tryb planowania wyłącza MCP; tryb zatwierdzania pokazuje działanie przed wykonaniem.
Spokojny interfejs, animowane struny i Discord Activity. Dopasuj swoją przestrzeń do pracy.
GOTOWY NA PIERWSZY POMYSŁ?
Wybierz system i zainstaluj AetherAI.
x64 · Instalator
Pobierz na Windows Wersja przenośna ↗Apple Silicon · arm64
Pobierz na macOS Mac Intel ↗x64 · AppImage
Pobierz na Linux Ubuntu / Debian (.deb) ↗Wersja 1.24.1
Na macOS i Linux zainstaluj Ollama do modeli lokalnych lub podłącz Ollama Cloud. Windows ma też wbudowany silnik.
Wersje macOS nie są podpisane ani notaryzowane przez Apple.
JESZCZE KILKA PYTAŃ
Czat lokalny jest bezpłatny. Dostawcy mają własne bezpłatne limity i płatne plany. Modele w chmurze wymagają klucza API.
Małe modele mogą działać na CPU. Wydajność zależy od sprzętu i pamięci. Modele chmurowe nie wymagają lokalnego GPU.
Na Windows x64: llama.cpp i Qwen 2.5 1.5B, około 1,14 GB, oraz Microsoft Visual C++, jeśli jest potrzebny. macOS i Linux korzystają z Ollama.
Linux: zainstaluj .deb na Ubuntu/Debian albo nadaj AppImage uprawnienia wykonywania; może być potrzebny FUSE. Mac: otwórz DMG i przeciągnij AetherAI do Aplikacji. Niepodpisana aplikacja może wymagać zgody w sekcji Prywatność i ochrona.
Otwórz GitHub Issues, podając wersję aplikacji, model i kroki odtworzenia błędu. GitHub Issues ↗